Server-Side-Tracking: wann es sich für Shops lohnt
Server-Side-Tracking verspricht vollständigere Daten und mehr Kontrolle. Was sich technisch tatsächlich ändert, was gleich bleibt — vor allem bei der Einwilligung —, welche Varianten es für Shops gibt und woran ein Projekt in der Praxis scheitert. Mit Belegen aus den Dokumentationen von Google, Meta und WebKit.
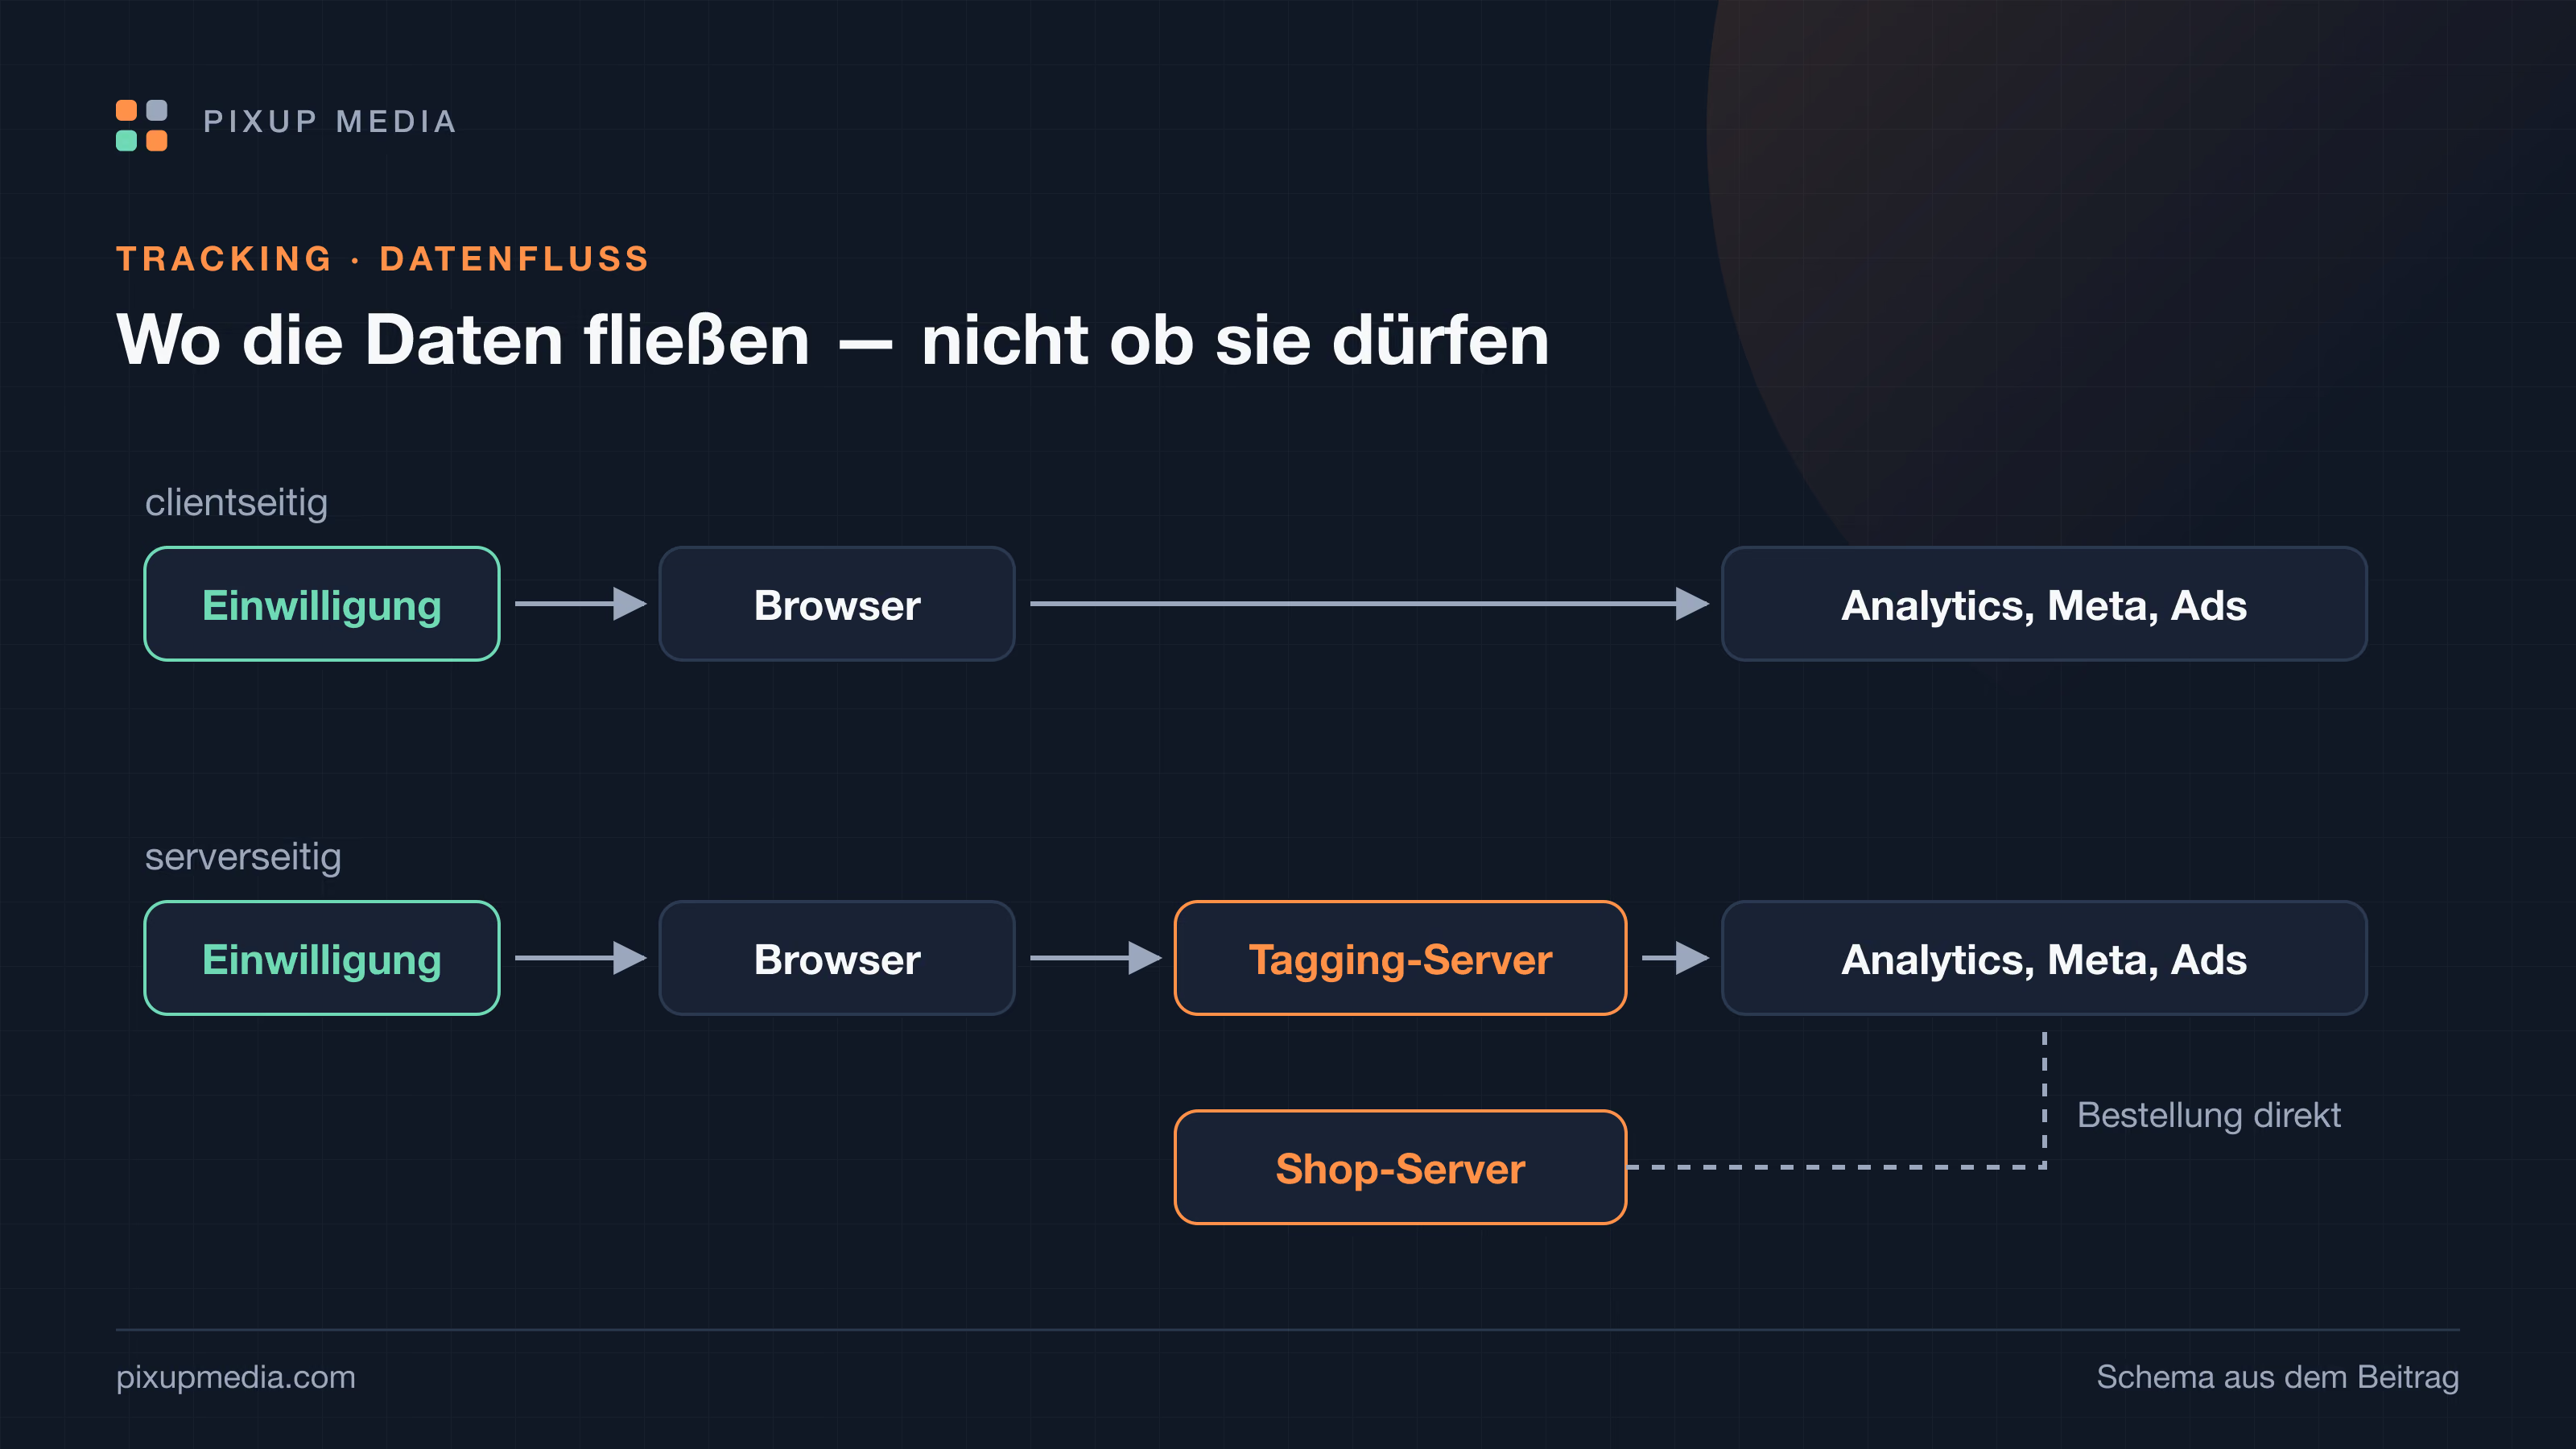
Kaum ein Tracking-Thema wird so oft als Lösung verkauft wie Server-Side-Tracking: vollständigere Daten, längere Cookies, weniger Verluste durch Werbeblocker. Ein Teil davon stimmt, ein Teil ist verkürzt — und ein Teil hängt an Bedingungen, die in Angeboten selten stehen. Dieser Beitrag sortiert, was sich technisch ändert und wann sich der Aufwand für einen Onlineshop lohnt.
Was sich ändert — und was nicht
Beim üblichen, clientseitigen Tracking sendet der Browser Messdaten direkt an die Dienste: an Google Analytics, an Meta, an das Werbenetzwerk. Beim serverseitigen Tracking geht der Weg über einen Server, den Sie selbst betreiben oder betreiben lassen. Dort wird entschieden, welche Daten in welcher Form an welchen Dienst gehen.
Was sich ändert:
- Kontrolle über die Weitergabe. Sie können Felder entfernen, kürzen oder vereinheitlichen, bevor Daten Ihr System verlassen.
- Weniger Skripte im Browser. Ein Tag-Server kann mehrere Dienste aus einem Datenstrom bedienen. Das kann die Seite entlasten, wenn tatsächlich Skripte wegfallen.
- Ereignisse aus dem Shop selbst. Eine Bestellung kann der Shop-Server melden, nachdem sie wirklich angelegt ist — unabhängig davon, ob der Browser die Bestätigungsseite lädt.
Was sich nicht ändert:
- Die Einwilligung. Ob für eine Messung eine Einwilligung nötig ist, hängt nicht davon ab, ob die Daten über den Browser oder über einen Server fließen. Das ist eine Rechtsfrage, die Ihre Rechtsberatung klärt. Technisch gilt: Ein serverseitiges Setup muss die Einwilligung genauso beachten wie ein clientseitiges.
- Was nicht gemessen wird, entsteht nicht. Lehnt jemand die Messung ab, gibt es auch serverseitig nichts weiterzugeben.
Der Punkt mit den Cookies
Ein häufig genanntes Argument sind längere Cookie-Laufzeiten in Safari. Die Grundlage dafür steht in der Dokumentation von WebKit: Seit der Version 2.1 der Intelligent Tracking Prevention sind dauerhafte Cookies, die per JavaScript gesetzt werden, auf eine Laufzeit von sieben Tagen begrenzt. Cookies, die der Server in seiner Antwort setzt, fallen nicht unter diese Regel.
Daraus wird gern geschlossen, ein Tag-Server auf einer eigenen Subdomain löse das Problem. So einfach ist es nicht: WebKit begrenzt seit 2020 auch Cookies auf sieben Tage, die aus Antworten einer Subdomain kommen, deren DNS-Eintrag per CNAME auf einen fremden Anbieter zeigt. Ob ein Setup darunter fällt, hängt davon ab, wie der Tag-Server angebunden ist — nicht vom Etikett „server-side".
Drei Varianten für Shops
1. Tagging-Server. Ein eigener Server, etwa der serverseitige Google Tag Manager, nimmt Ereignisse aus dem Browser an und verteilt sie. Google nennt für den Betrieb auf Cloud Run etwa 45 US-Dollar pro Monat je Server und empfiehlt mindestens zwei, damit bei einem Ausfall keine Daten verloren gehen. Dazu kommen Einrichtung und Pflege.
2. Direkte Schnittstellen aus dem Shop. Werbenetzwerke wie Meta bieten Schnittstellen, über die der Shop-Server Ereignisse direkt meldet — bei Meta die Conversions API. Das braucht keinen Tag-Server, aber eine Anbindung im Shop, in Shopware etwa über ein Plugin oder eine eigene Erweiterung.
3. Beides zusammen. Browser und Server melden dasselbe Ereignis, damit möglichst wenig verloren geht. Dann muss jedes Ereignis doppelt erkennbar sein: Meta verlangt dafür in Browser und Server dieselbe Ereignis-ID und denselben Ereignisnamen. Fehlt das, werden Käufe doppelt gezählt.
Woran Projekte scheitern
- Doppelte Ereignisse. Browser und Server senden denselben Kauf, ohne gemeinsame Kennung. Die Zahlen sehen besser aus, sind aber falsch.
- Einwilligung nicht durchgereicht. Der Server erhält Ereignisse, ohne zu wissen, wozu der Besucher zugestimmt hat. Dann leitet er weiter, was er nicht dürfte.
- Niemand ist zuständig. Ein Tag-Server ist ein weiteres System mit Updates, Kosten und Ausfällen. Ohne Betreuung läuft er still falsch.
- Kein Abgleich mit den Bestellungen. Ob das Setup stimmt, zeigt nur der Vergleich mit den tatsächlichen Bestellungen im Shop — nicht die Zahl im Werbekonto.
Wann es sich lohnt
Fünf Fragen vor der Entscheidung
- 1Hängt nennenswertes Werbebudget an Conversion-Daten? Dann zählt jede verlorene oder doppelte Bestellung.
- 2Stimmt das bestehende Tracking? Wer clientseitig falsch misst, misst serverseitig genauso falsch — nur aufwendiger.
- 3Wollen Sie steuern, welche Daten an wen gehen? Das ist der klarste Vorteil eines Tag-Servers.
- 4Gibt es jemanden, der den Server betreibt? Updates, Überwachung, Kosten.
- 5Können Sie das Ergebnis messen? Vorher und nachher gegen die Bestellungen im Shop.
Für einen kleinen Shop mit wenig Werbung ist die Antwort meist: zuerst das bestehende Tracking sauber machen. Für Shops, deren Werbebudget an den Daten hängt, kann sich ein serverseitiges Setup lohnen — wenn Einwilligung, Deduplizierung und Betrieb von Anfang an mitgeplant sind.
Wie Besuche aus KI-Assistenten in solchen Daten auftauchen und warum sie sich schwer zuordnen lassen, beschreibt KI-Traffic richtig einordnen.
Server-Side-Tracking ändert, wo Daten fließen — nicht, ob sie fließen dürfen. Es lohnt sich, wenn Werbebudget an den Daten hängt und jemand das System betreibt.
Wenn Sie Ihr Tracking prüfen oder serverseitig neu aufsetzen wollen, beschreibt unsere Seite Tracking und Analytics, wie wir vorgehen. Eine Anbindung direkt im Shop entwickeln wir unter App- und Plugin-Entwicklung.